Data lake genérico
sobre apache hadoop
Repositorio masivo de datos estructurados y no estructurados,
con ingesta en tiempo real, búsqueda inteligente y análisis con Machine Learning.
Un lago de datos
inteligente y abierto
El Data Lake de Sinte es un repositorio de almacenamiento que contiene grandes cantidades de datos en bruto — estructurados y no estructurados — y los mantiene hasta que sea necesario analizarlos. A diferencia de un data warehouse jerárquico, utiliza una arquitectura plana basada en HDFS.
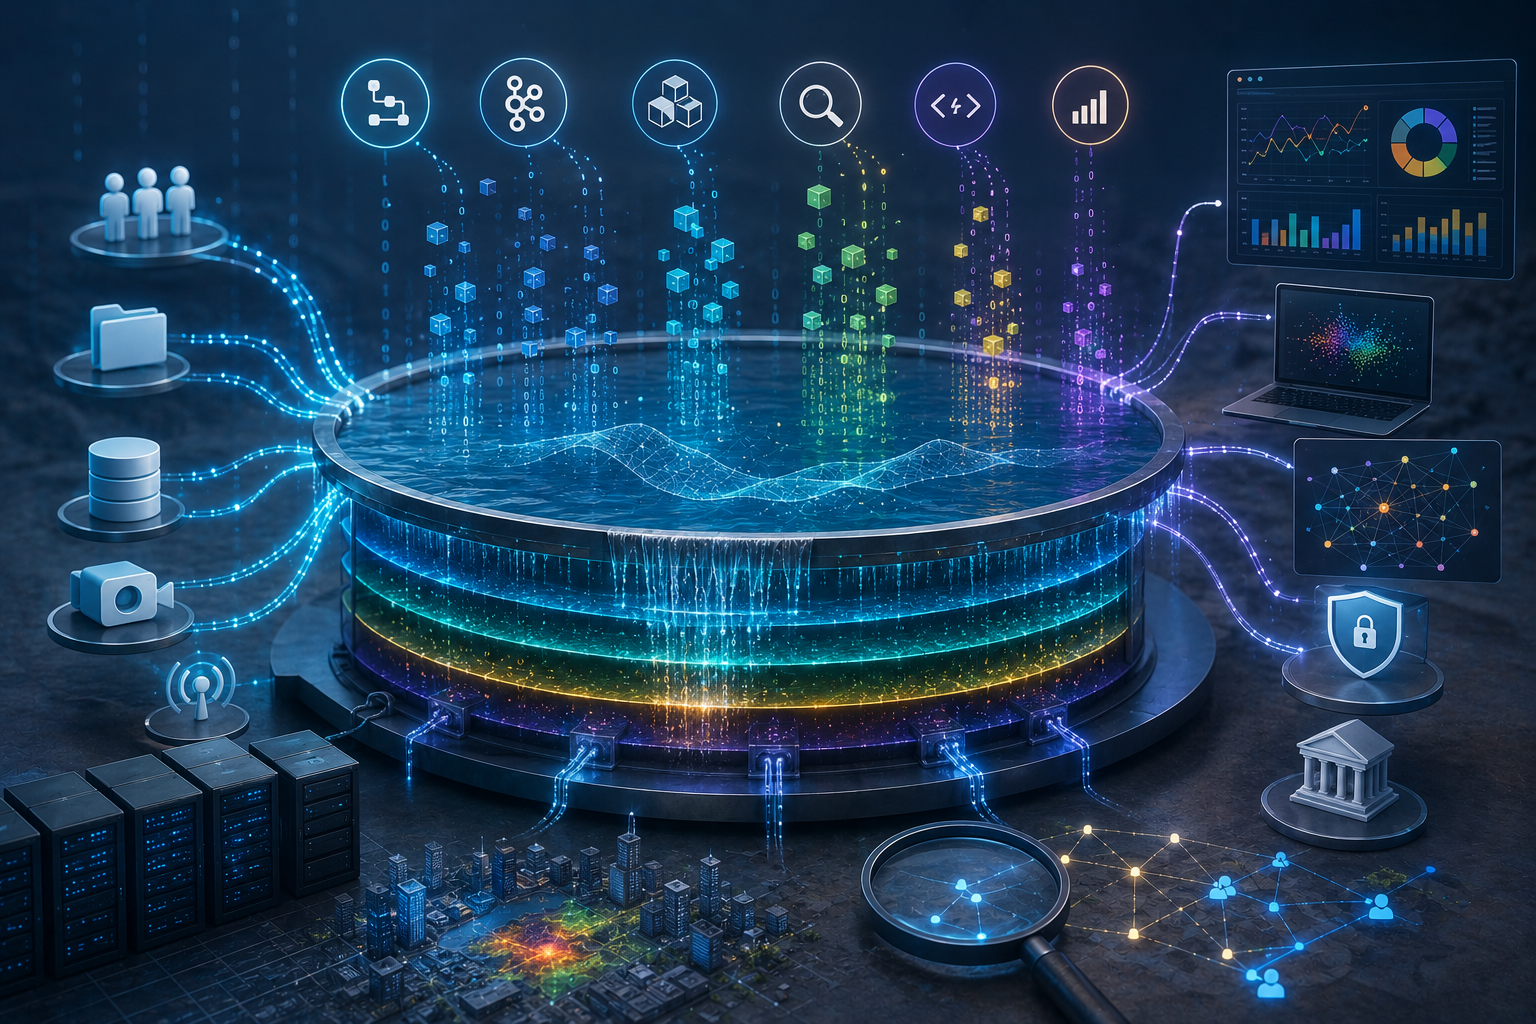
Construido sobre el ecosistema Apache Hadoop, integra herramientas open source de clase mundial para ingesta (NiFi, Kafka), almacenamiento (HBase), búsqueda (Solr), ciencia de datos (Zeppelin) y visualización (Banana).
La solución está especialmente orientada a inteligencia contra el crimen, lucha contra el lavado de activos (AML) y análisis de seguridad pública, con integración a portales de búsqueda AML y herramientas de análisis de vínculos como IBM i2.
Solicitar ConsultoríaIngesta masiva
Captura datos de SIEM, PSIM, CDRs, redes sociales, Deep Web y más — de forma continua y en tiempo real.
Búsqueda inteligente
"Encontrar la aguja en el pajal": localice patrones, relaciones y transacciones en millones de registros en millisegundos.
Machine Learning
Modelos predictivos con Python y R sobre Apache Zeppelin para detección de anomalías y análisis forense de datos.
Los 4 cuadrantes de datos
Supervisión en tiempo real de sistemas transaccionales con datos de estructura conocida.
Datos estructurados de fuentes no identificadas previamente, accedidos vía conectores web.
Documentos no estructurados de fuentes conocidas, procesados con Apache Tika.
Integración de redes sociales y fuentes abiertas para inteligencia de amenazas.
¿Por qué adoptar un
Data lake inteligente?
Compartir datos
Establezca canales seguros y gobernados para que distintos equipos e instituciones compartan datos sin perder trazabilidad ni control de acceso.
Integrar datos
Unifique fuentes heterogéneas (SIEM, PSIM, CDRs, SAR, redes sociales) en un único repositorio con esquema flexible y arquitectura plana.
Encontrar datos
Localice la información crítica en millisegundos con búsqueda full-text sobre Apache Solr. "Encontrar la aguja en el pajal" es el objetivo central.
Ordenar datos
Clasifique, indexe y catalogue automáticamente todos los datos ingeridos para facilitar el acceso, la auditoría y el cumplimiento regulatorio.
Combinar datos
Cruce información interna (transaccional, operacional) con fuentes externas (web, redes sociales, reportes de inteligencia) para análisis enriquecido.
Stack apache hadoop
integrado por Sinte
Apache NiFi
Captura e importa datos de múltiples fuentes en tiempo real con flujos visuales configurables. Filtra el "ruido" y mejora la calidad antes del almacenamiento.
Apache Kafka
Sistema publish/subscribe distribuido, particionado y replicado. Rápido, escalable y tolerante a fallas para flujos de mensajes masivos con baja latencia.
Apache Tika
Transforma documentos no estructurados (PDF, Word, HTML, XML, MP3, imágenes) en Metadata + Texto procesable por el motor de análisis.
Apache HBase
Base de datos no relacional open source modelada sobre Google BigTable. Se ejecuta sobre HDFS, proporcionando capacidades BigTable para Hadoop.
Apache Solr
Motor de búsqueda basado en Lucene con APIs XML/HTTP y JSON. Búsqueda por facetas, resaltado de resultados y caché de alto rendimiento.
Apache Zeppelin
Plataforma de ciencia de datos con intérpretes de Python y R. Machine Learning y Deep Learning directamente sobre los datos del lago.
Apache Banana
Dashboards ejecutivos con histogramas, nubes de términos, mapas y gráficas en tiempo real para la toma de decisiones estratégicas.
Portal Tramix / I2
Portal de búsqueda AML con búsqueda múltiple, filtros avanzados y exportación a IBM i2 Analyst's Notebook para análisis de vínculos e inteligencia.
Plan de trabajo
en 8 sprints
Sprints de 2 semanas con Daily Scrum, demos internas/externas y entrega incremental del producto. Mejora continua basada en feedback de usuarios finales y stakeholders.